从"天"级到"小时"级: VirtualFlow 原生 GPU 求解器做了什么
VirtualFlow 原生 GPU 求解器在相变液冷仿真中的应用
2026-10-19
为什么 AI 时代的仿真,先要解决"生产问题"
高保真数值仿真,是工程世界离物理真相最近的地方。但在数据驱动的研发范式下,它有一个尴尬的身份:AI 模型训练数据的唯一生产者,自己却还停留在手工作坊时代。
矛盾是结构性的,一共有四组:
快与慢——单次求解动辄数小时,训练一个可用的代理模型却需要数百个样本。数据集的构建周期,以月计。
精密与脆弱——网格、边界条件、收敛控制,每个环节都拴着专家经验,且都可能静默失败:过程不报错,结果不可信。
收敛与正确——求解器正常退出,从来不等于物理正确。错误数据一旦混入训练集,模型会"认真地学错",而且几乎无法事后察觉。
经验与资产——每更换一类仿真对象,整套流程推倒重来。经验留在了工程师脑子里,没有沉淀为可复用的体系能力。
我们的答案,是一套端到端的全自动化体系:一端把数据生产做成工业产线(数据工厂),一端让每个仿真对象拥有秒级响应的数字孪生。四组矛盾,对应四项关键技术。
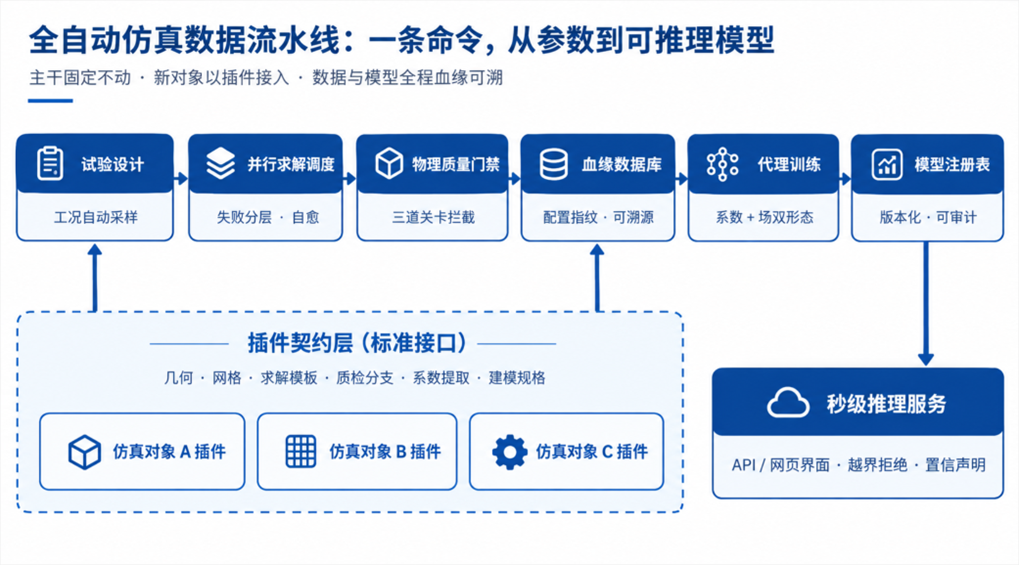
图1 全自动仿真数据流水线总体架构
关键技术一:无人值守的全自动流水线
从试验设计、并行求解到质量裁决、血缘入库,全链路一条命令驱动。核心设计是失败的分层治理:基础设施故障自动重试,数值故障隔离跳过,结构性故障立即熔断——机器处理可预期的意外,人只处理真正意外。
对固定几何场景,网格只剖分一次、集中验收,后续数百个工况克隆复用。单例成本结构性下降,网格缺陷也从"逐例随机出现"变为"一次性拦截"。
效果是直观的:晚上提交命令,早晨收获数百例带完整血缘的高质量数据。
关键技术二:多道物理质量门禁——让"假收敛"无处遁形
收敛,是求解器的自我声明;正确,是物理的客观事实。两者之间,需要一道系统的防线。
我们在流水线的不同深度布设了多道门禁:网格阶段对边界分类做强制校验,错配在源头拦截;求解输出施加物理量级熔断,发散结果无所遁形;收敛判据从单一残差升级为"残差或积分物理量稳定"的双重认证——个别工况下残差会撒谎,积分量不会。
在此之上,每条数据绑定配置指纹与完整血缘:可溯源、可审计、可按指纹精确隔离。数据质量管理,从"靠人盯"变为"靠系统拦"。
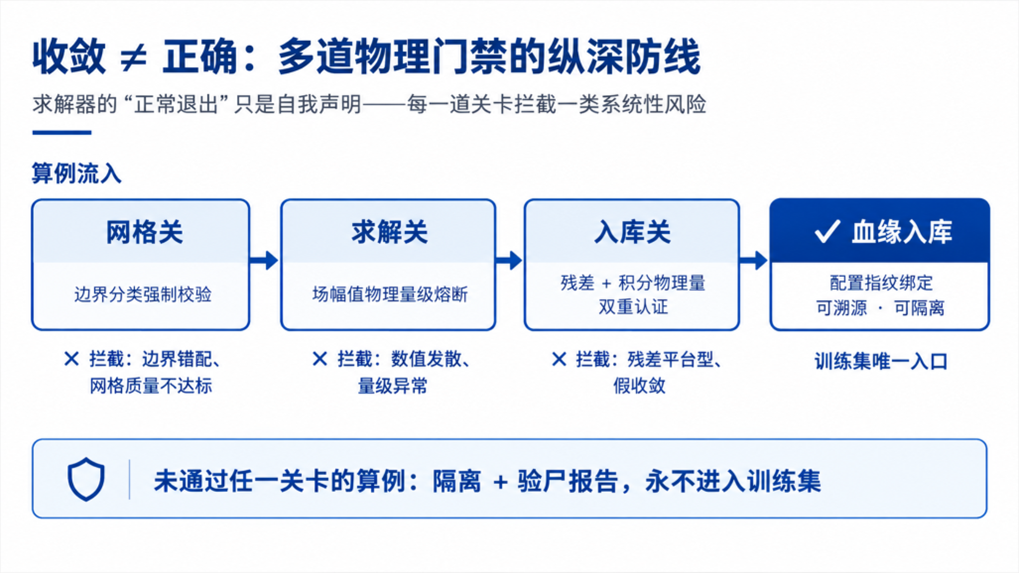
图2 多道物理门禁的纵深防线
关键技术三:插件化架构——一次建设,处处复用
流水线本体与具体仿真对象之间,由一套插件契约解耦:新对象只需实现一组标准接口——几何、网格、求解、质检、提取、建模规格——即可接入全套自动化能力,主干零改动。
这套架构已在多类差异巨大的对象上完成验证。新增一类仿真对象的边际成本,从"重建一条流水线",降为"实现一个插件"。体系的能力开始复利增长。
关键技术四:可信的代理建模——不只快,更要诚实
数据入库之后,便进入体系的另一端:把数小时的求解,压缩成秒级的预测。代理建模分两种形态:标量系数的集成代理,与全流场的神经算子代理。三条设计哲学贯穿始终:
数据的表达,比模型的结构更决定上限。
以物理相似性做无量纲化、以时间平均场做训练目标,带来的精度提升远超架构调参。
物理先验,是最有效的正则。
引入经典相似律重新参数化后,高维问题坍缩为低维曲线,精度与稳定性同步提升。
可信,比全能更重要。
集成方差为每个预测附上置信声明;对存在物理分岔、无法可靠拟合的区间,模型明确拒答而非强行输出;训练域外的请求,一律拒绝外推。
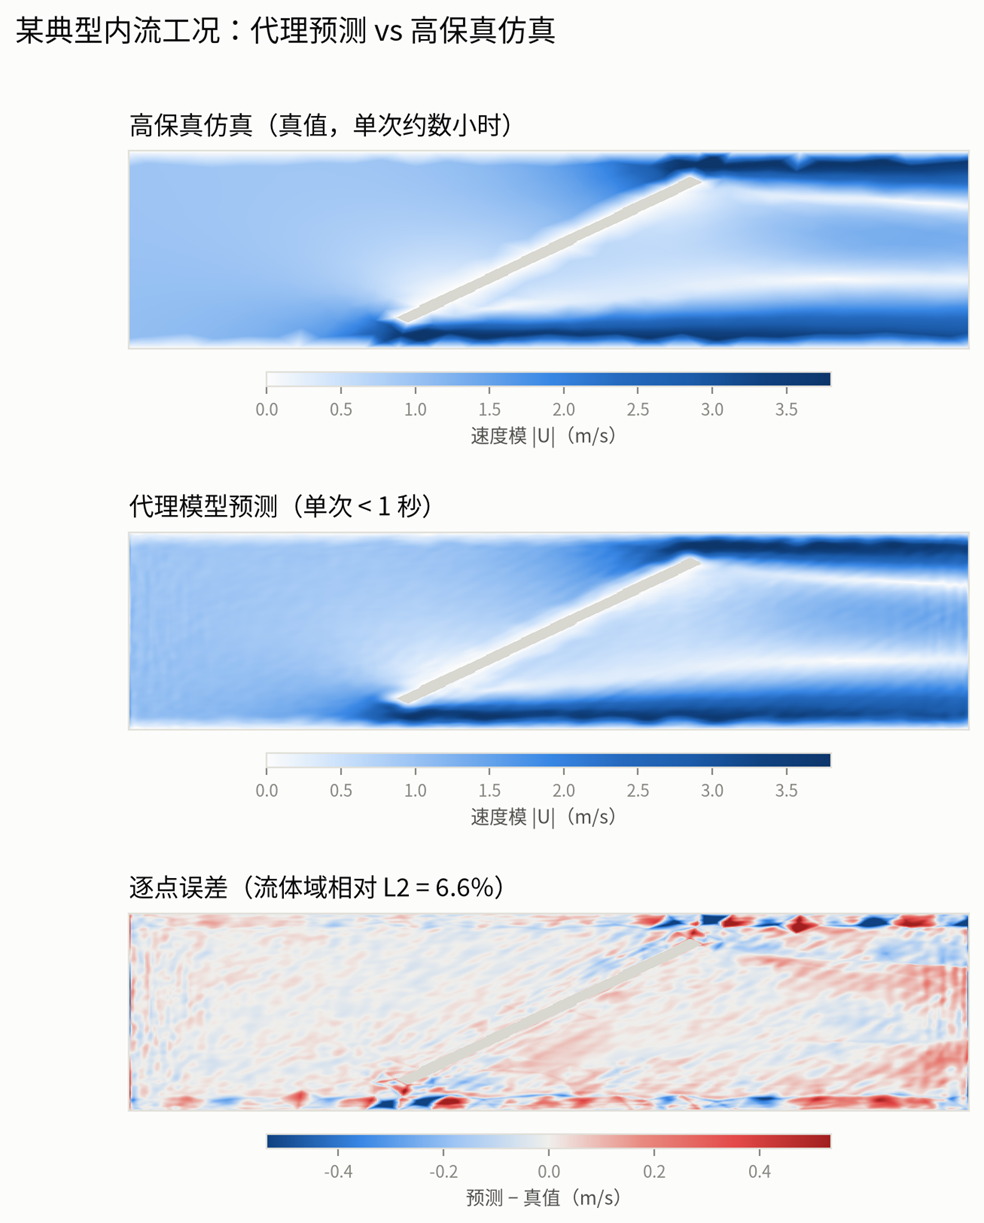
图 3 某典型内流工况:代理预测与高保真仿真对比(流体域相对误差 6.6%)
闭环:从数据工厂到数字孪生
训练与推理由统一编排收口:一条命令完成数据生产、模型训练与注册;推理端自动路由、内置越界检查,冷启动约两秒;网页端提供训练、模型库、推理的完整界面。
最终形态是:每个仿真对象,对应一个注册在案的数字孪生体——秒级响应,知道自身边界,每个数字都能溯源到具体算例。
结语
从数小时到秒级,是四个量级的加速。但更本质的转变在于:数据生产从手工作坊,变为可审计、可复用、可自愈的工业产线;模型输出从"一个数字",变为"一个带置信声明的承诺"。
AI 工程化的难点,从来不在模型本身,而在供养模型的整套体系。
这,正是"数据工厂"存在的意义。
官方微信
扫码关注
